Чтобы очеловечить текст нейросети, мало заменить в нём слова. Нейросети хорошо имитируют человеческую речь, их ответы на первый взгляд выглядят убедительно и последовательно. Но эта убедительность рассыпается, стоит всмотреться пристальнее. Черновик модели и итоговый текст редактора в наших замерах совпадают только на 16–27% символов. Между «что-то связное написано» и «это можно выпускать» лежит большая дистанция.
Мы редакция editors.one, больше семи лет работаем на фрилансе: пишем и редактируем тексты, готовим сценарии и курсы для компаний. Ниже шесть типовых ошибок модели, которые мы нашли, когда сравнивали её черновики с текстами редактора, и пример «было → стало» к каждой. Дальше порядок редактуры от смысла к словам и то, что стоит написать в промте, то есть в запросе к модели, чтобы правок стало меньше.
Что редактор меняет в тексте нейросети
Мы собрали 234 пары текстов. Это письма и пуш-уведомления, которые крупный онлайн-сервис рассылает своим пользователям. Каждая пара состоит из черновика модели и версии, которую выпустил редактор. Модель писала не наугад. Она получала описание задачи, примеры удачных текстов и правила стиля проекта.
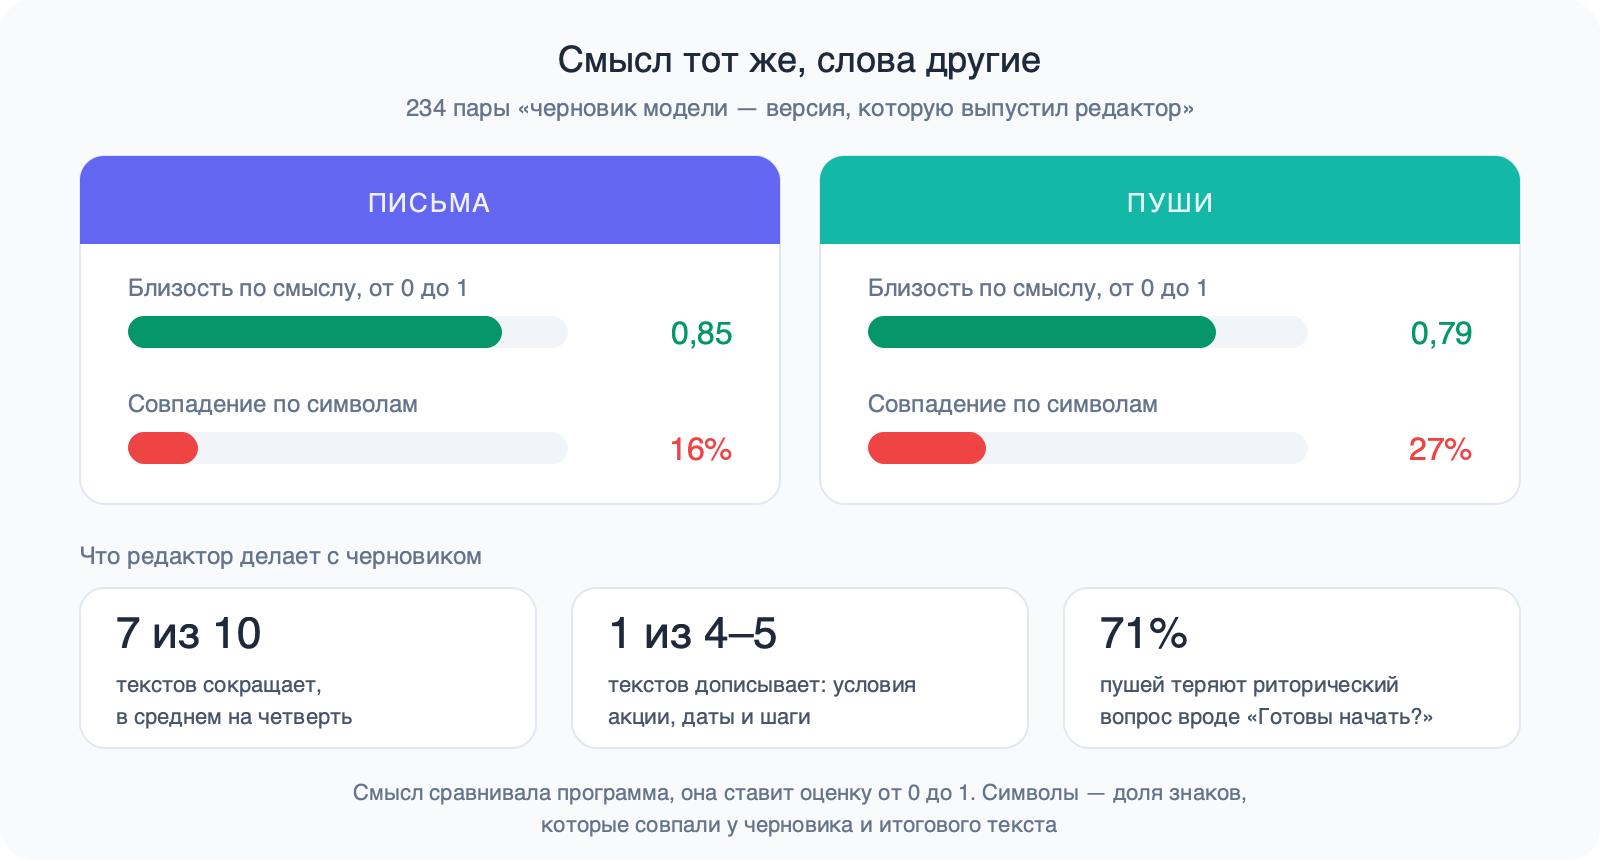
Модель попадает в смысл. Мы сравнивали черновик и итоговый текст по смыслу специальной программой, которая ставит оценку от 0 до 1: у писем вышло 0,85, у пушей 0,79. Слова при этом почти все другие. Посимвольно черновик и итоговый текст совпадают на 16% у писем и на 27% у пушей.
Редактор чаще режет, чем дописывает. Он сокращает примерно семь текстов из десяти, в среднем на четверть. Он же дописывает каждый четвёртый или пятый текст, потому что модель не дала условий акции, дат и шагов. Редактор убирает эмодзи больше чем из половины текстов, а риторический вопрос вроде «Готовы начать?» убирает из 71% пушей. Слова «поможет», «получите», «больше» уходят, на их место приходят «как», «если», «можно». Вместо обещания скидки появляется условие, при котором скидка действует.
Почему текст нейросети звучит как нейросеть
Языковая модель просто предсказывает наиболее вероятное продолжение текста. Но наиболее вероятное — это среднее: среднее слово, средний оборот, средняя структура. Можно регулировать настройки генерации, но результат всё равно вращается вокруг средней точки. Если текст от нейросети вам подходит, значит, вы принимаете средний результат.
Если слишком опираться на нейросеть, тексты постепенно становятся «нормальными», но похожими на всё вокруг. Для массового потока это терпимо. Для автора, которого выбирают по портфолио, это уже риск: текст теряет не грамотность, а характер.
Ещё нейросети создают иллюзию готового текста. Вроде пуш и пуш, но в одном таком пуше нейросеть просто додумала, что товары «нравятся другим», хотя в задании этого не было. Если не придать значения мелочам, можно выпустить текст, который запутывает, создаёт ложные ожидания или просто обманывает.
Часть ошибок появляется ещё до генерации. Позже мы нашли в этом же проекте сбой. Программа, которая собирала запрос к модели, теряла по дороге факты задачи: даты, суммы, условия акций. Модель видела описание задачи, примеры и правила стиля, но не видела самих фактов. Поэтому часть того, что редактор дописывал, модель просто не могла знать. Если вы пишете с моделью в чате, вывод простой: всё, что модель должна знать, нужно положить в запрос самому.
Шесть типовых ошибок модели
Профессиональная редактура — это сильная селекция. Редактор удаляет лишнее и не идёт в красивую, но неверную сторону. Он не добавляет фальшивую конкретику и не переусердствует с убедительностью. Нейросети по своей природе скорее достраивают и заполняют, чем осторожно отказываются от лишнего.
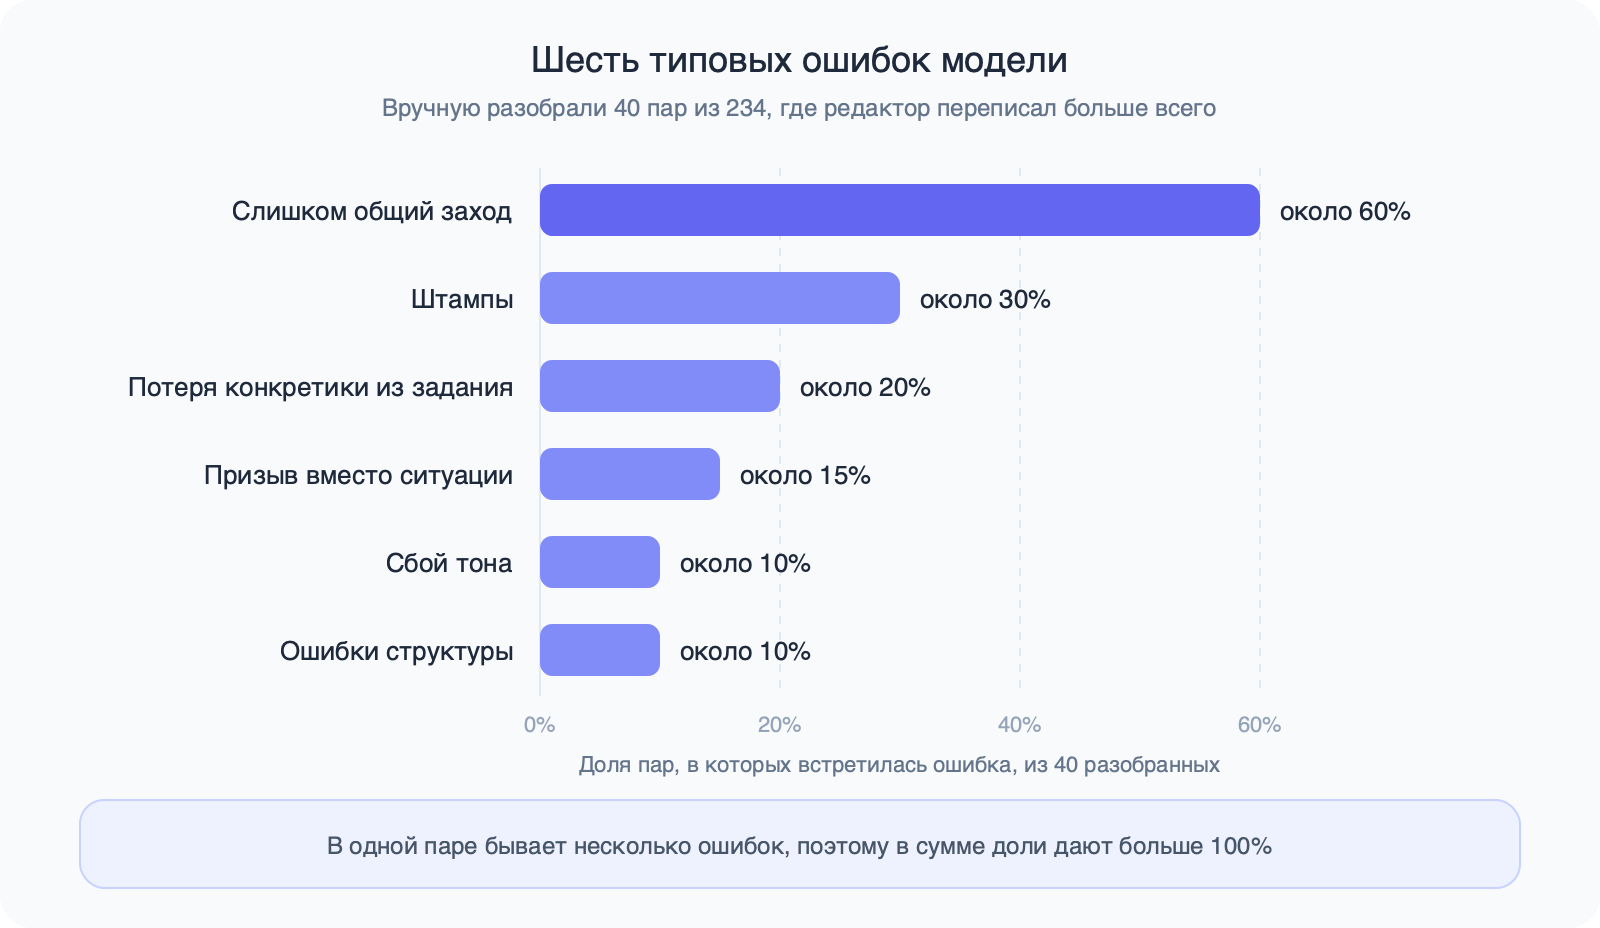
Мы вручную разобрали 40 пар из 234, где редактор переписал больше всего, и записали по каждой, в чём промах. Ошибки сложились в шесть повторяющихся типов. Доли ниже считаются от этих 40 пар. В сумме они больше 100%, потому что в одной паре бывает несколько ошибок. Примеры «было → стало» мы придумали на материале фриланса, чтобы показать ту же ошибку на знакомых задачах.
1. Слишком общий заход — около 60% разобранных пар
Модель часто пишет правдоподобно, но не очень хорошо чувствует, зачем именно текст существует. Редактор тонко расставляет акценты. Он решает, что сказать и что опустить, что вынести вперёд и что смягчить.
Было: тема письма онлайн-школы для фрилансеров «Новые возможности для вашей карьеры». Стало: «Как ответить клиенту, который просит скидку». Внутри письма урок как раз про ответ на просьбу о скидке, и новая тема говорит об этом прямо.
Было: отклик на бирже «Здравствуйте! Я опытный копирайтер и с радостью помогу с вашим проектом». Стало: «Здравствуйте! Посмотрел ваш магазин. В карточках платьев нет состава ткани и размерной сетки. Могу дописать их для 40 карточек за неделю».
Общий заход легко проверить. Спросите себя, подойдёт ли эта фраза соседней задаче. Если подойдёт, угол не найден.
2. Штампы — около 30%
Модель пишет стандартные фразы: «Время для выгоды», «Индивидуальный подход к каждому клиенту», «Откройте для себя новые горизонты». Мы заметили при разборе, что штампы грамматически правильны и стилистически нейтральны. Это и есть то самое среднее слово и средний оборот, поэтому модель их генерирует. Информации в них нет.
Было: описание в портфолио «Создаю качественные тексты, которые решают задачи бизнеса». Стало: «Пишу статьи для блогов юридических фирм. Ссылки на законы проверяю по действующим редакциям».
Штамп не лечится синонимом. Напишите вместо штампа, что вы делаете, для кого и с каким результатом.
3. Потеря конкретики из задания — около 20%
Даже для очень короткого текста нейросети нужно знать сразу несколько вещей. Ей нужны технические ограничения и стилистические требования, а главное, суть того, о чём она пишет. Если суть до модели не дошла, она заменяет её общими словами. Редактор возвращает то, что было в задании: сумму, дату, название, условие.
Было в задании: лендинг за 10 рабочих дней, 25 000 ₽, два круга правок, предоплата 50%. Модель написала: «Предлагаю гибкие условия сотрудничества и прозрачное ценообразование». Стало: «Сделаю лендинг за 10 рабочих дней. Стоимость 25 000 ₽, в неё входят два круга правок. Половину суммы прошу до начала работы, вторую половину после сдачи».
Эта ошибка работает и в обратную сторону. Модель добавляет в текст то, чего в задании нет, как в примере с товарами, которые «нравятся другим». Наш редактор пишет на такие места коротко: «Зачем эта деталь? И с чего вы вообще взяли?» Он советует убирать любые детали, которые вы добавляете для правдоподобности примера. Такие детали делают текст хуже.
4. Призыв вместо ситуации читателя — около 15%
Модель часто пишет тему письма в повелительном наклонении. Она смотрит из системы наружу и описывает, как устроена услуга. Наш редактор разбирал такую ошибку на пуше о доставке из другого города: «Пользователь не думает категориями „другой город“ — он думает „понравилась вещь, хочу получить“». Редактор меняет призыв на ситуацию, в которой читатель себя узнаёт.
Было: «Обновите портфолио». Стало: «Если отклики на бирже остаются без ответа».
Было: «Повысьте цены». Стало: «Когда клиентов больше, чем часов в неделе».
5. Сбой тона — около 10%
Модель переходит на «ты» и берёт жаргон и эмодзи не в тон читателю. Она злоупотребляет одним и тем же набором эмодзи: подарки, ракеты, галочки, деньги.
Было: «Залетай за первыми заказами 🔥». Стало: «Как получить первый заказ на бирже».
Тон ломается и тогда, когда модель говорит о деле читателя свысока. Однажды модель назвала товары продавца мелочью. Наш редактор написал на полях: «Если я продаю трактора, что из них мелочь? Это что за оскорбление читателя?» Рекламная интонация тоже относится к сбою тона. «Получите больше клиентов» обещает результат, за который автор не отвечает. Редактор пишет «Как найти клиентов, если…» и называет условие.
6. Ошибки структуры — около 10%
Модель может ошибаться в фактах, путать ограничения, пропускать части инструкции, нарушать формат, даже когда запрос кажется чётким. Например, языковая модель не умеет считать. Не получится просто ей сказать: «Напиши пуш, заголовок — 18 символов». Поэтому заголовок у неё превращается в развёрнутое предложение, одно и то же слово стоит в заголовке и в первой строке, а длинное письмо идёт сплошным потоком. Когда текст не влезает в лимит, модель режет фразу. Наш редактор отвечает на это так: «Нельзя резать готовую фразу до огрызка, чтобы влезло».
Было: в заголовке рассылки стоит целое предложение «Мы подготовили для вас подборку советов, которые помогут найти первых клиентов». Первая строка письма повторяет его: «Найти первых клиентов непросто». Стало: заголовок «Где искать первых клиентов». Первая строка «Собрали пять мест, откуда к нашим выпускникам пришли первые заказы».
| Ошибка | Доля из 40 пар | Что проверить |
|---|---|---|
| Общий заход | ~60% | Подойдёт ли фраза соседней задаче |
| Штампы | ~30% | Есть ли во фразе факт |
| Потеря конкретики | ~20% | Все ли цифры и условия задания на месте |
| Призыв в теме | ~15% | Описана ли ситуация читателя |
| Сбой тона | ~10% | «Вы» или «ты», жаргон, эмодзи |
| Структура | ~10% | Заголовки, повторы, сплошной текст |
Как редактировать текст нейросети: сначала смысл, потом слова
Мы редактируем по методу Людмилы Сарычевой, соавтора книги «Пиши, сокращай». Метод идёт от крупного к мелкому. Сначала редактор проверяет смысл и факты, потом устройство предложений, слова в самом конце. Если начать со слов, вы отполируете фразы, которые на первом шаге всё равно уйдут из текста.
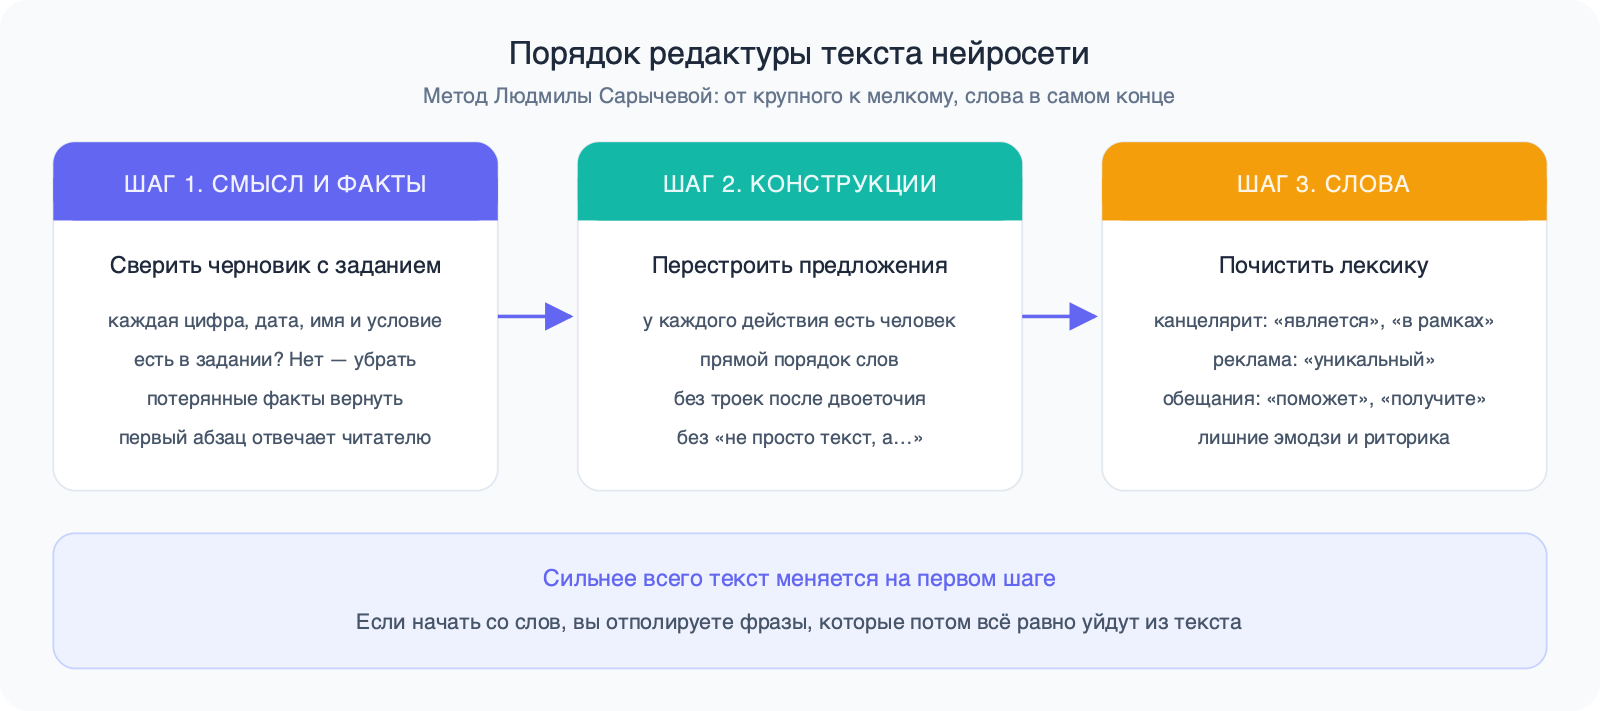
Шаг 1. Смысл и факты
Положите рядом задание заказчика и черновик модели и пройдите по ним так.
- Найдите в задании каждую цифру, дату, имя и условие из черновика. Чего в задании нет, уберите или уточните у заказчика.
- Найдите в задании факты, которых нет в черновике, и верните их в текст.
- Спросите про каждое утверждение, откуда оно известно. Наш редактор пишет на полях короче: «Зачем эта деталь? Или дожми, или убери».
- Проверьте, отвечает ли первый абзац на вопрос читателя.
Текст часто меняется на этом шаге сильнее всего. Если факты не сошлись, черновик проще написать заново по заданию, чем латать.
Шаг 2. Конструкции
Модель строит предложения, которые выглядят как объяснение, хотя внутри пусто. Автоматические проверки и списки стоп-слов такие места пропускают, их видно только при чтении. Вот шесть конструкций, которые мы правим в текстах модели постоянно.
- Абстракция действует вместо человека. Было: «Правильный подход обеспечивает результат». Здесь нет того, кто действует, поэтому читатель не понимает, что делать ему. Стало: «Если вы согласуете план до текста, правок будет меньше».
- Тройка после двоеточия. Было: «Фриланс даёт всё: свободу, деньги, гибкость». Три слова после двоеточия изображают полноту, а читатель не узнаёт ничего нового. Стало: «На фрилансе вы сами решаете, сколько заказов брать в месяц».
- Противопоставление вместо объяснения. Было: «Это не просто текст, а инструмент продаж». Стало: «Текст объясняет, чем ваш курс отличается от бесплатных роликов».
- Обратный порядок слов. Было: «Правки заказчик пришлёт в пятницу». Фраза звучит как перевод. Стало: «Заказчик пришлёт правки в пятницу».
- Безличная фраза там, где действует человек. Было: «Сроки обсуждаются индивидуально». Стало: «Срок назову, когда прочитаю задание».
- Тире в каждом абзаце. Наш редактор режет их со словами «Тире экономим. Это нейромаркер», то есть признак, по которому читатель узнаёт текст модели. Перестройте предложение так, чтобы связь между частями называл союз.
Шаг 3. Слова
Только теперь очередь слов. Уберите канцелярит вроде «является», «осуществлять», «в рамках», рекламные слова вроде «уникальный» и «инновационный», пустые обещания «поможет» и «получите». Проверьте эмодзи и риторические вопросы. Метод Сарычевой предлагает простой тест. Слово, которое нельзя сказать вслух за чаем, лучше заменить.
Чистка слов полезна читателю, но оценку детектора ИИ она почти не меняет. Мы проверили это на статьях нашего блога и разобрали результаты в статье детектор ИИ-текста: что он показывает.
Промт для ИИ-копирайтера: что дать модели до генерации
Ошибки из списка выше проще предупредить, чем исправлять. Мы сравнивали модель, которую специально дообучили на парах «черновик → версия редактора», с обычной моделью. Обычная модель с подробным заданием справилась не хуже дообученной. Качество определил контекст в задании.
Хороший промт похож на хорошее техническое задание. Вот что в него положить.
- Задачу и читателя: кто прочитает текст и что он сделает после.
- Все факты: цифры, даты, суммы, условия, названия. Модель не знает того, чего нет в промте, поэтому додумывает недостающее сама.
- Ограничения по длине и формату. Отдельно укажите, обращаться к читателю на «вы» или на «ты».
- Правила стиля: что вы в этом проекте не пишете. Список запретов полезнее просьбы «пиши живо».
- Пример. Возьмите свой прошлый текст похожего жанра вместе с черновиком модели, из которого он получился, и положите оба в промт. По такой паре модель видит, что вы исправляли. Если пары пока нет, сохраните её после первого же заказа.
Модели проще воспроизводить паттерн, чем понимать его из описания. Мало сказать «пиши в таком-то стиле», полезнее показать, как выглядела задача, какой был контекст и какой текст на выходе вы сочли хорошим. Пример готового текста сам по себе не помогает модели построить путь к нему. Лучше работает связка из вводных, чернового результата и результата после человека. Тогда видно не только что получилось, но и что именно пришлось исправлять.
Задача: письмо клиенту с предложением о сотрудничестве.
Читатель: владелец интернет-магазина одежды, после письма он должен ответить, интересно ли ему.
Факты: 40 карточек товаров без состава ткани и размерной сетки; срок 7 дней; цена 12 000 ₽; два круга правок.
Ограничения: до 600 знаков, обращение на «вы», без эмодзи.
Не писать: «индивидуальный подход», «качественные тексты», «с радостью помогу», риторические вопросы.
Пример: черновик модели из прошлого заказа и моё итоговое письмо по нему.
Просить три варианта и выбирать лучший почти бесполезно. Мы проверяли и это. Мы брали из трёх вариантов тот, что ближе всех к версии редактора, и сравнивали его с обычным вариантом. Сходство с версией редактора выросло всего на 0,06 по шкале от 0 до 1. Разнообразие появляется от задания, а не от числа попыток.
Подборка сервисов, которыми фрилансеры пользуются для текстов и не только, есть в статье AI-инструменты для фрилансера в 2026 году.
Почему нейросеть плохо находит ошибки в своём тексте
Кажется логичным отдать черновик второй модели на проверку. Мы так и сделали и дали модели 15 правил стиля, 60 вариантов текста и попросили найти нарушения и исправить их. Модель переписала 58 вариантов из 60. Если попросить модель найти ошибки, она находит их почти всегда.
С людьми бывает так же. Когда вас просят «принять работу», немного некомфортно сразу сказать «всё отлично». Это такая психологическая ловушка: когда вас просят внимательно что-то изучить, вы автоматически переходите в режим всезнающего критика и ищете ошибки, даже если на самом деле их нет. Поэтому иногда комментарии дают для того, чтобы что-то написать. Ведь не писать совсем ничего немного неловко.
У человека такие комментарии выглядят безобидно: «к примеру» вместо «например» и «в том же духе» вместо «в том же стиле». У модели хуже. Она меняла термины: «продвижение» становилось «рекламой», «страховка» превращалась в «полис». Заказчик получает уже другой текст, а такую правку легко пропустить.
Есть такое редакторское правило: называть обратную связь не правками, а комментариями. Правки вы безоговорочно принимаете и бежите исправлять, а комментарии — это просто мысли, которые можно обсудить. Мы применили ту же идею к модели и разделили оценку и правку. Один запрос только отмечает проблемы, другой их исправляет. Ещё мы сузили роль проверяющего до корректора. Корректор может переставить слова, убрать лишнее, сократить и поправить пунктуацию. Менять термины и формулировать смысл заново ему нельзя. Если проблема требует новой формулировки, текст уходит человеку. Модель после этого переписала 24 варианта из 60 вместо 58, остальные она признала чистыми.
Если проверяете черновик через чат, напишите в запросе прямо, что чистый текст — нормальный результат. Запретите модели менять термины и смысл, а отмеченные места разберите сами.
Сколько закладывать на редактуру
Черновик модели приходится сверять с заданием и перестраивать. По нашим наблюдениям, нейросеть экономит не больше трети времени даже в самых шаблонных задачах. Для сметы из этого следует простое правило. Если без нейросети текст занимает у вас 6 часов, с нейросетью закладывайте не меньше 4 часов. Цену за текст снижайте не больше чем на треть, а срок называйте по своей обычной скорости редактуры. Как считать цену, если вы пишете с нейросетью, мы разобрали в статье заменит ли ИИ копирайтеров и сколько брать за тексты. Что модель делает хорошо, описано в статье нейросеть для копирайтера: что она умеет, общие правила цены есть в руководстве как ставить цены на услуги фрилансера.
Частые вопросы
Как очеловечить текст нейросети?
Сверьте черновик с заданием, верните потерянные факты и уберите додуманные. Потом перестройте предложения так, чтобы у каждого действия был человек и прямой порядок слов. Уберите тройки после двоеточия и противопоставления. В конце замените канцелярит и штампы, уберите лишние эмодзи и риторические вопросы. Если начать со слов, ошибки в фактах останутся в тексте.
Сколько текста нейросети приходится переписывать?
По нашим 234 парам «черновик модели → версия редактора» черновик и итоговый текст совпадают только на 16–27% символов, остальное редактор перенабирает. При этом по смыслу они близки: модель попадает в тему и задачу. Редактор сокращает примерно семь текстов из десяти и дописывает каждый четвёртый или пятый.
Можно ли попросить нейросеть отредактировать свой текст?
Можно, но просьба «найди ошибки» почти всегда заканчивается тем, что модель переписывает весь текст. Когда мы так сделали, модель переписала 58 вариантов из 60. Лучше разделить оценку и правку и запретить модели менять термины и смысл. Тогда она работает как корректор, а смысловые места остаются человеку.
Какой промт дать нейросети, чтобы правок было меньше?
Дайте задачу и читателя, все факты с цифрами и датами, ограничения по длине и формату, список того, что в проекте писать нельзя. Добавьте пример: свой прошлый текст и черновик модели, из которого он получился. Без фактов модель додумывает недостающее, а без примера пишет средний текст.
Поможет ли редактура пройти детектор ИИ?
Почти не поможет. Мы проверяли статьи нашего блога детектором Pangram. Статьи, которые писала модель, после чистки от штампов всё равно получали 78–100% «AI». Оценка упала до 0–18%, только когда мы собрали статьи заново на фразах, примерах и историях из курса про фриланс, который написали сами. Редактура нужна читателю, а детектор оценивает другое.