Детектор ИИ-текста оценивает, насколько текст похож на то, что пишет языковая модель. Он смотрит на текст целиком, а не ищет отдельные «нейросетевые» слова. Поэтому, если убрать из текста модели штампы вроде «индивидуального подхода», детектор почти всегда продолжит считать его машинным.
Мы редакция editors.one, больше семи лет работаем на фрилансе: пишем и редактируем тексты, готовим сценарии и курсы для компаний. Мы проверяем статьи этого блога детектором Pangram и ниже расскажем, что он показал. Ещё разберём, какие детекторы есть для русского языка и что делать автору, чей текст пометили как ИИ, и заказчику, который получил такой результат.
Как работает детектор ИИ-текста
Детектор — это тоже модель. Разработчики обучают её на большом наборе текстов, про которые известно, кто их написал: человек или нейросеть. Потом детектор получает новый текст и оценивает, насколько вероятно, что его сгенерировала модель.
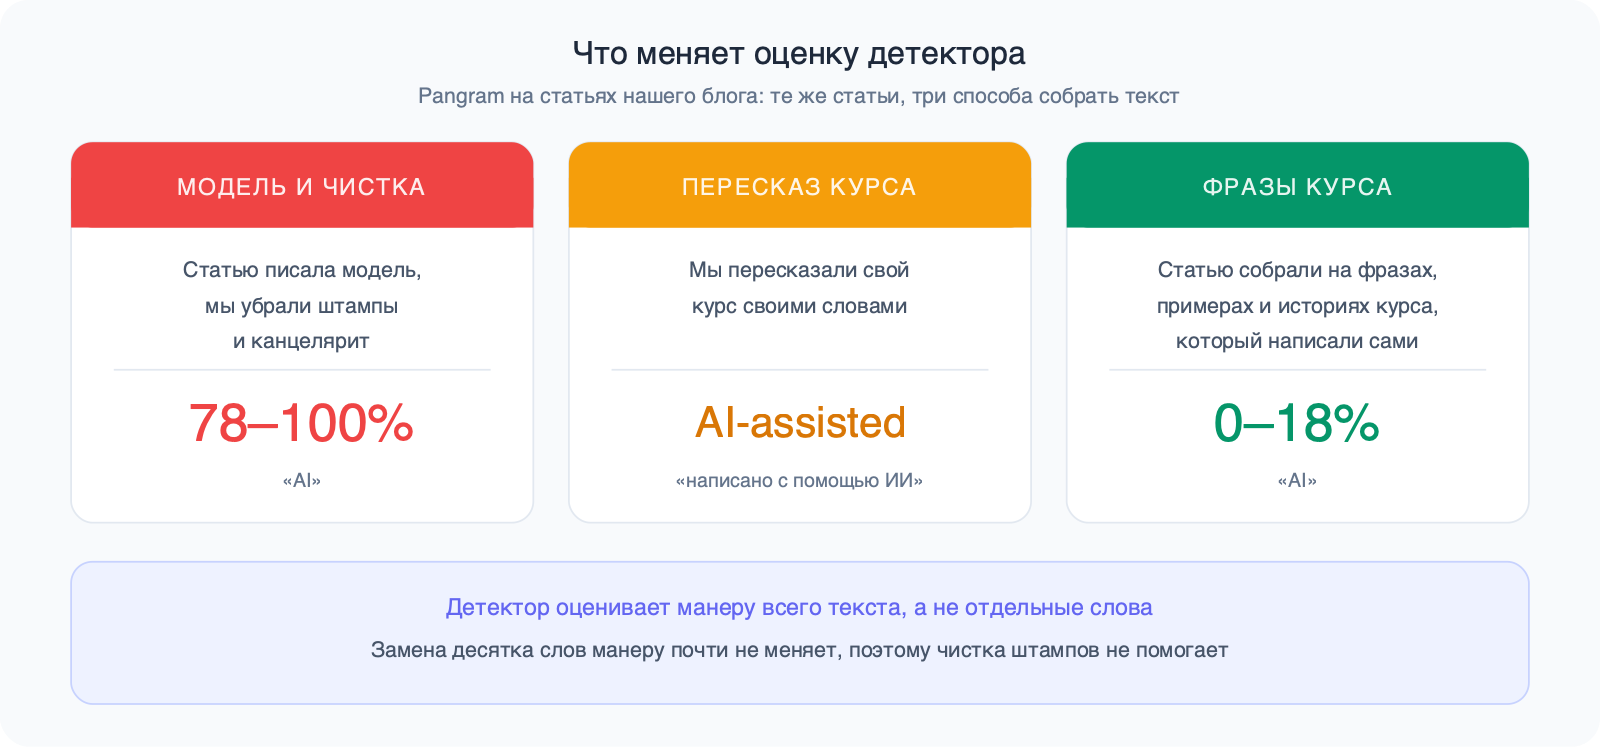
Языковая модель просто предсказывает наиболее вероятное продолжение текста. Но наиболее вероятное — это среднее: среднее слово, средний оборот, средняя структура. Можно регулировать настройки генерации, но результат всё равно вращается вокруг средней точки. Детектор учится узнавать эту среднюю манеру по всему тексту. Замена десятка слов манеру почти не меняет. Мы видели это на своих статьях.
Детектор не знает, кто писал текст. Он видит только сам текст. Сухой шаблонный текст, который написал человек, тоже может получить высокую оценку.
Детекторы хуже оценивают короткие тексты, чем длинные. Поэтому у сервисов есть нижний порог. GigaCheck принимает тексты от 20 слов, «Антиплагиат» проверяет документы объёмом от двух листов.
Результат детектора — вероятность. Разработчики это признают. «Антиплагиат» пишет в памятке для проверяющих, что доказательств в этой области быть не может: нельзя со стопроцентной уверенностью сказать, что текст написала нейросеть.
Детекторы ИИ-текста на русском языке
Ниже сервисы, которые работают с русским языком. Цифры точности заявили сами компании, независимой проверки этих цифр мы не нашли.
| Сервис | Кому доступен | Что заявляет разработчик |
|---|---|---|
| Нейродетектор Яндекса | Только преподавателям, в кабинете Яндекс Образования | Выводы — рекомендация, точность не публикуется |
| GigaCheck, Сбер | Демо-версия на сайте и Telegram-бот | Узнаёт 94,7% сгенерированных текстов |
| «Антиплагиат» | Пользователям системы «Антиплагиат» | Ложных срабатываний не больше 1% |
| Pangram | Сайт и API | Точность выше 99% |
Есть ли детектор ИИ-текста у Яндекса
Яндекс запустил «Нейродетектор» в марте 2025 года как инструмент для преподавателей. Он работает только в личном кабинете преподавателя на сайте Яндекс Образования и помогает проверять эссе, рефераты и другие письменные работы. Яндекс подчёркивает, что выводы Нейродетектора — рекомендация для преподавателя, решение остаётся за ним. Мы не нашли у Яндекса сервиса, где проверить текст может любой человек.
Детектор ИИ-текста от Сбера: GigaCheck
Сбер показал GigaCheck в июне 2024 года. Демо-версия работает на официальной странице GigaCheck, там же Сбер упоминает Telegram-бот. Демо проверяет тексты от 20 до 1000 слов.
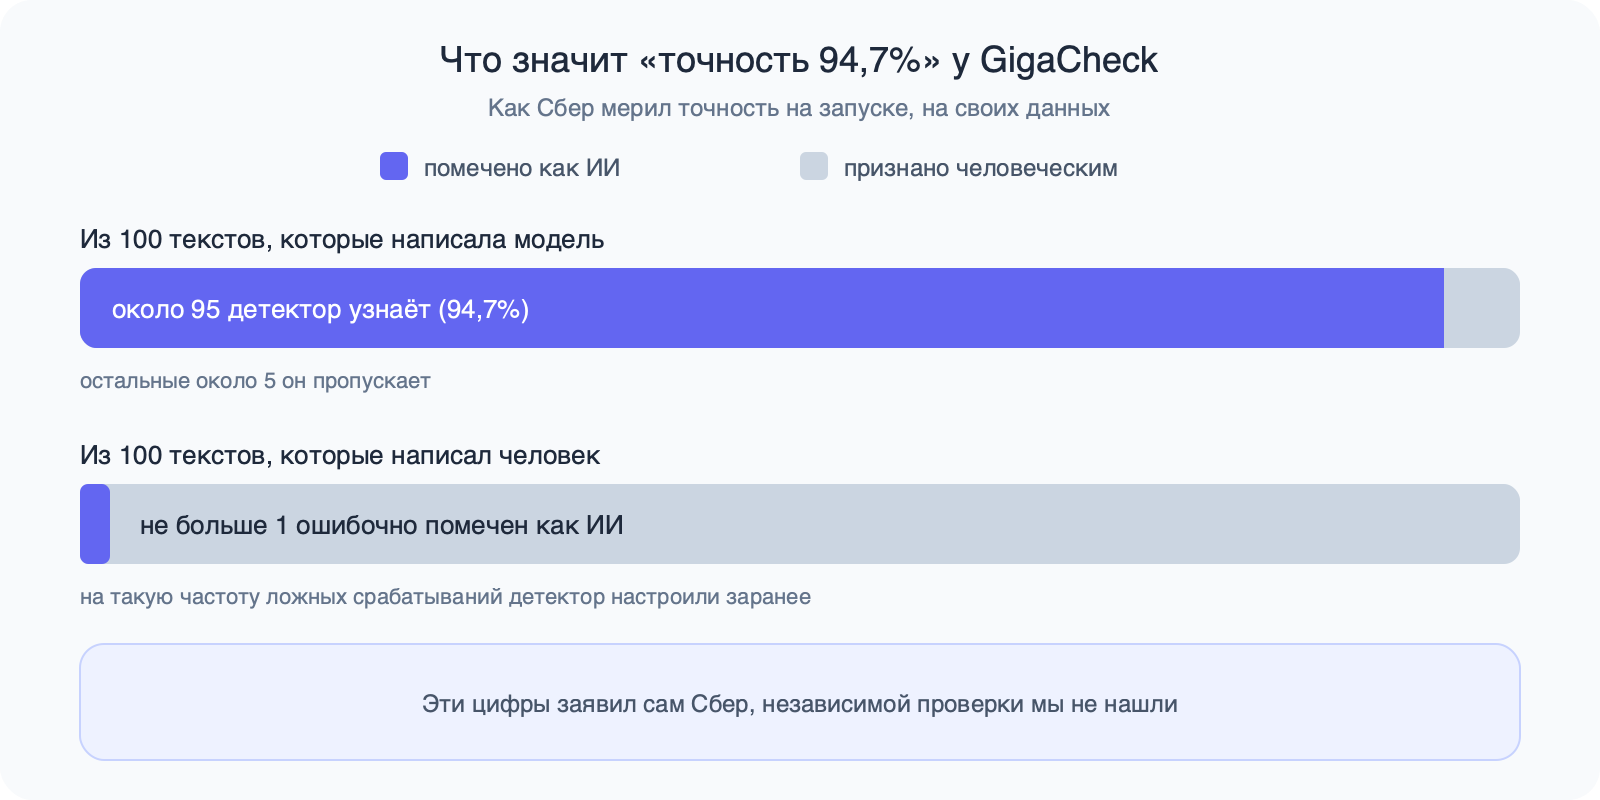
Сбер на запуске заявил точность 94,7% и мерил её так. Детектор настроили ошибаться на человеческих текстах не чаще чем в 1 случае из 100. Детектор с такой настройкой узнал 94,7% сгенерированных текстов. Получается, из 100 текстов модели GigaCheck узнаёт около 95, а из 100 человеческих примерно один ошибочно помечает как ИИ. Эти цифры Сбер получил на своих данных.
«Антиплагиат»
«Антиплагиат» встроил детектор сгенерированного текста в обычную проверку на заимствования. Детектор работает с русским, английским и казахским языками и с документами объёмом от двух листов. Компания пишет, что ложное срабатывание возможно, но вероятность ошибки не больше 1%.
Компания советует проверяющему не останавливаться на отметке детектора и смотреть на содержание. В памятке перечислены признаки, на которые стоит обратить внимание: выдуманные факты, недостоверные ссылки, сбои логики, повторы и «вода».
Pangram
Pangram — зарубежный детектор, его мы и используем. Компания пишет, что он работает больше чем с 20 языками. Русский среди них есть: мы проверяли им свои статьи. Он делит текст на фрагменты и про каждый решает, написал его человек, модель или человек с помощью модели.
Какой детектор ИИ-текста лучше
Мы не нашли большого независимого сравнения детекторов на русском языке. Есть небольшой тест на Хабре: в июле 2026 года автор проверил несколько детекторов, среди них GigaCheck, детектор Текст.ру и зарубежный GPTZero, на 18 сгенерированных текстах разной длины и 3 человеческих. Сам автор предупреждает, что выборка маленькая.
Все детекторы в этом тесте определяли длинные тексты почти без ошибок, а на коротких ошибались заметно чаще. GigaCheck отметил как ИИ фрагмент человеческого текста, доклада ООН 2018 года. Когда автор пересказал сгенерированный текст с помощью второй нейросети, GigaCheck и Текст.ру признали пересказ человеческим.
Назвать лучший детектор по этим данным нельзя. Если вы всё же проверяете текст, берите длинный фрагмент, сравнивайте несколько сервисов и читайте результат как сигнал.
Наш опыт: что детектор показал на статьях блога
Pangram показывает для каждого текста процент «AI». Это доля текста, которую детектор отнёс к сгенерированному. 100% значит, что детектор считает машинным весь текст, 0% значит, что ни одного фрагмента.
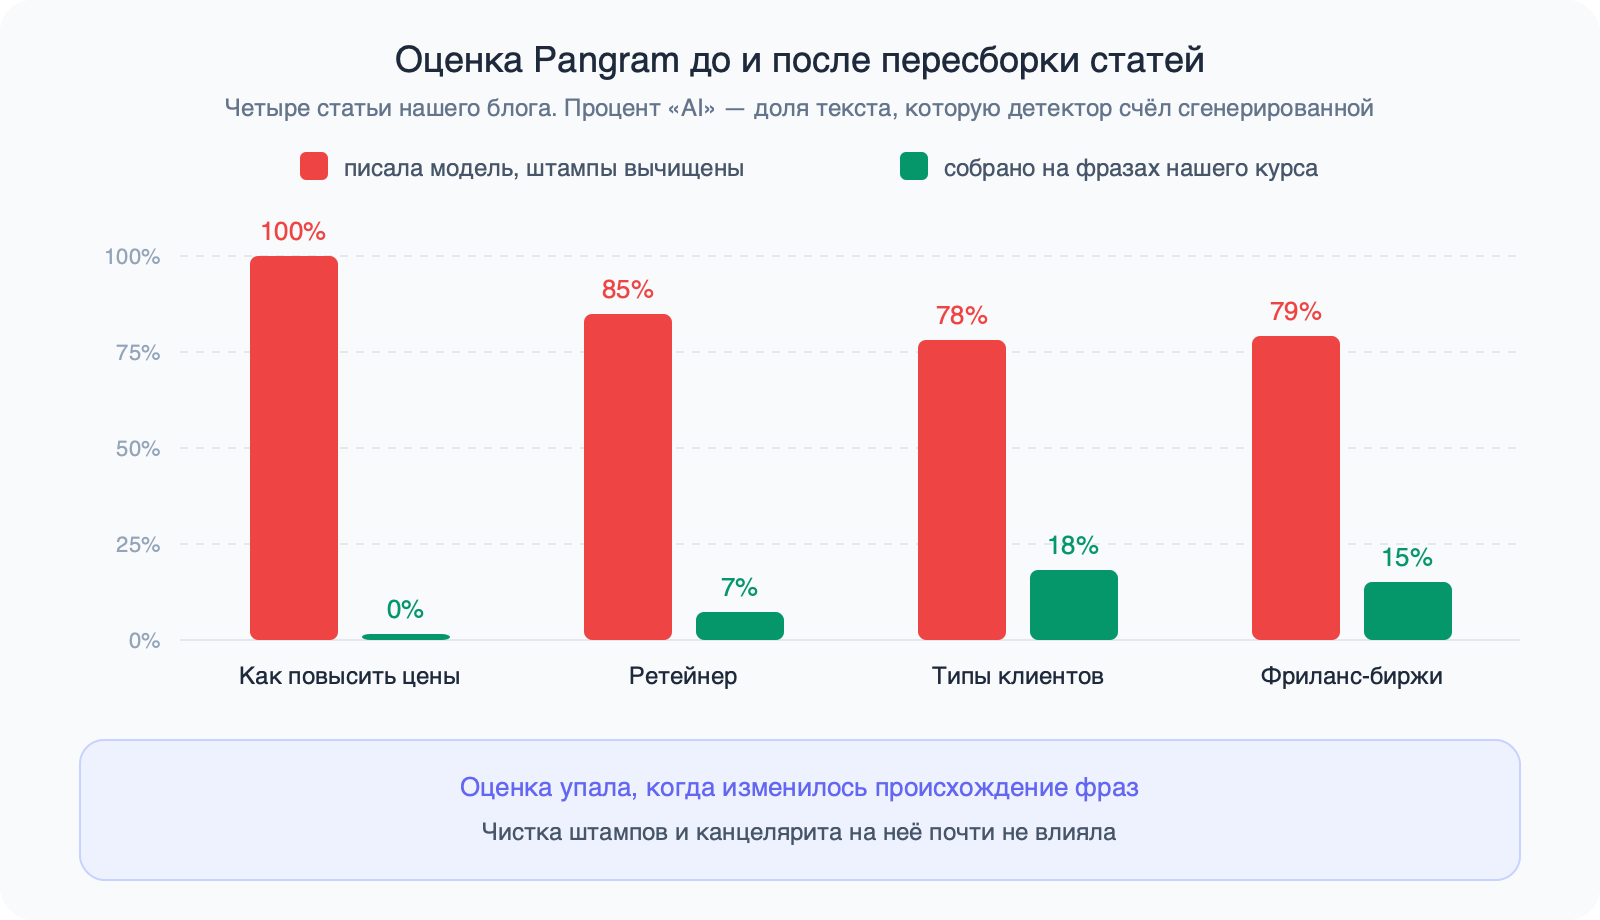
Часть статей этого блога сначала писала модель, а мы редактировали и убирали из них штампы и канцелярит. Такие статьи всё равно получали от Pangram 78–100% «AI».
Потом мы собрали эти статьи заново. Мы взяли за основу курс про фриланс, который когда-то написали сами. Мы строили статьи на его исходных фразах, примерах и историях. Оценка после этого упала с 78–100% до 0–18%. Мы пробовали и пересказывать курс своими словами. Такой пересказ Pangram относил к промежуточной группе «AI-assisted», то есть «написано с помощью ИИ».
| Статья | «AI», когда текст писала модель | «AI», когда текст собран на фразах курса |
|---|---|---|
| Как повысить цены на фрилансе | 100% | 0% |
| Ретейнер для фрилансера | 85% | 7% |
| Типы клиентов на фрилансе | 78% | 18% |
| Международные фриланс-биржи | 79% | 15% |
Оценка упала, когда изменилось происхождение фраз. Чистка слов на неё почти не влияла.
Одна закономерность держалась при любой переработке. Блоки частых вопросов и шаблоны договоров внутри статей оставались помеченными как «AI», даже когда вся статья получала низкий процент. Мы думаем, что дело в предсказуемом языке: люди пишут договоры и короткие ответы на вопросы похоже друг на друга, и модель пишет их так же. Если ваш текст состоит из таких блоков, высокая оценка не говорит о том, кто его писал.
Мы пересобирали статьи, потому что их правда писала модель. Детектор для нас — способ найти места, где мы слишком на неё положились. Мы всё равно решаем, выпускать ли статью, после редакторского чтения. Мы описали, как редактируем текст после модели, в статье как отредактировать текст после нейросети.
Что делать, если ваш текст пометили как ИИ
Допустим, заказчик прислал скриншот с оценкой «90% ИИ», а вы писали сами. Первая реакция на такое обвинение рождается неосознанно, она продиктована инстинктами и эмоциями. Когда на вас нападают, организм будет защищаться, даже если вы об этом не думаете. Кто-то инстинктивно ругается в ответ, кто-то расстраивается. Поэтому сразу отвечать заказчику в письме или в мессенджере — неудачная идея.
Чтобы ответ не был продиктован эмоциями, сначала надо охладиться. Возьмите паузу, перечитайте сообщение, постарайтесь расслабиться. Если всё ещё хочется эмоционально настаивать на своей правоте, лучше сходить на обед, взять кофе или просто позаниматься другой рабочей задачей. Скорее всего, через пару часов станет легче. Потом действуйте по шагам.
- Не додумывайте за заказчика. Пока не поняли, что у клиента болит, не беритесь его лечить. Уточните, каким сервисом он проверял, какой процент получил, какие фрагменты сервис отметил и какой длины был текст. Если заказчик напишет что-то непонятное, переспросите.
- Соберите следы работы: черновики, заметки, расшифровки интервью, список источников, историю версий документа. По истории версий видно, как текст рос и менялся.
- Договоритесь о звонке, лучше с видео. Проверено: человек, который оставляет резкие комментарии, будет гораздо мягче во время звонка. У него включатся механизмы социально приемлемого поведения. Он не станет кричать на незнакомца, будет обращаться на «вы» и подробнее объяснит, что его смутило.
- Помните, что звонок — общение двух равноправных сторон, а не суд над вами. Не извиняйтесь, не стесняйтесь задавать много вопросов и не соглашаться, приводите аргументы из своего опыта. Вы такой же равноправный участник процесса, как и клиент. Закончить проект и получить полезный текст — в ваших общих интересах.
- Если проверку детектором на старте не обсуждали, не стесняйтесь сказать клиенту, что вы так не договаривались.
Если текст ваш, переписывать его ради другой цифры бессмысленно. Детекторы расходятся в оценках, а текст от такой переделки лучше не станет. Если вы пользовались нейросетью, скажите честно, на каком этапе и для чего, например для плана или для поиска формулировок.
Если вы писали сами, первое сообщение заказчику может выглядеть так.
Здравствуйте! Текст я писал сам, могу показать черновики и историю версий документа. Подскажите, каким сервисом вы проверяли и какие фрагменты он отметил? Предлагаю созвониться и пройтись по тексту: так будет быстрее, чем переписываться. Мне удобно в среду в любое время.
На следующие заказы договоритесь о проверке заранее. Пропишите в техническом задании или в договоре, можно ли пользоваться нейросетями и на каких этапах. Там же договоритесь, проверяет ли заказчик тексты детектором, каким именно и что вы делаете, если результат спорный.
Что делать заказчику
Относитесь к оценке детектора как к комментарию: всё, что он говорит, важно, но необязательно истинно. Разработчики сами это признают. Яндекс называет выводы своего детектора рекомендацией, «Антиплагиат» пишет, что доказательств в этой области быть не может.
Низкая оценка тоже ничего не гарантирует. В тесте на Хабре GigaCheck и Текст.ру признали человеческим сгенерированный текст, который пересказала вторая нейросеть.
Нейросеть не гарантирует ни корректность, ни стиль, но и человек их не гарантирует. Поэтому проверяйте то, за что вы платите. Сверьте факты, цифры, даты и ссылки, проверьте, выполнил ли автор задание и полезен ли текст читателю. «Антиплагиат» в своей памятке советует то же: если в тексте есть выдуманные факты, ложные ссылки, сбои логики, повторы или «вода», это уже повод вернуть его на доработку, кто бы его ни писал.
Если оценка кажется странной, спросите автора, как шла работа. Попросите показать черновики и пройтись по тексту вместе. Такой разговор скажет о тексте больше, чем процент.
Не судите по оценке договоры и ответы на частые вопросы: у нас Pangram помечал такие блоки как «AI», даже когда вся статья получала низкий процент. Короткий текст тоже лучше не проверять детектором, на нём детекторы ошибаются чаще.
Если вам важно, чтобы автор не писал с нейросетью или привлекал её только на отдельных этапах, скажите об этом до начала работы. Мы разобрали, что нейросеть делает хорошо и где текст после неё приходится переписывать, в статье нейросеть для копирайтера: что она умеет.
Частые вопросы
Какой детектор ИИ-текста лучше для русского языка?
Мы не нашли большого независимого сравнения. Сбер заявлял для GigaCheck 94,7% на своих данных, «Антиплагиат» обещает не больше 1% ложных срабатываний, Яндекс цифр не публикует. Надёжнее проверить длинный текст в нескольких сервисах и не считать результат доказательством.
Есть ли детектор ИИ-текста у Яндекса?
Есть «Нейродетектор», но только для преподавателей: он работает в их личном кабинете на сайте Яндекс Образования. Мы не нашли у Яндекса сервиса, где проверить текст может любой человек.
Можно ли проверить текст на ИИ онлайн?
Можно попробовать демо-версию GigaCheck на официальной странице Сбера для разработчиков. Она принимает тексты от 20 до 1000 слов. Условия использования лучше уточнить на самой странице.
Может ли детектор принять текст человека за ИИ?
Может. Детектор видит только текст и оценивает вероятность. Блоки частых вопросов и шаблоны договоров в наших статьях оставались помеченными как «AI», даже когда вся статья получала низкий процент, а GigaCheck в тесте на Хабре отметил как ИИ доклад ООН.
Поможет ли убрать штампы, чтобы детектор не считал текст ИИ?
Почти не поможет. Наши статьи, которые писала модель, после чистки от штампов всё равно получали 78–100% «AI». Оценка упала, только когда мы собрали статьи заново на фразах, которые написали люди.